
Skalierbare Segment- und Subsegment-Struktur in HubSpot
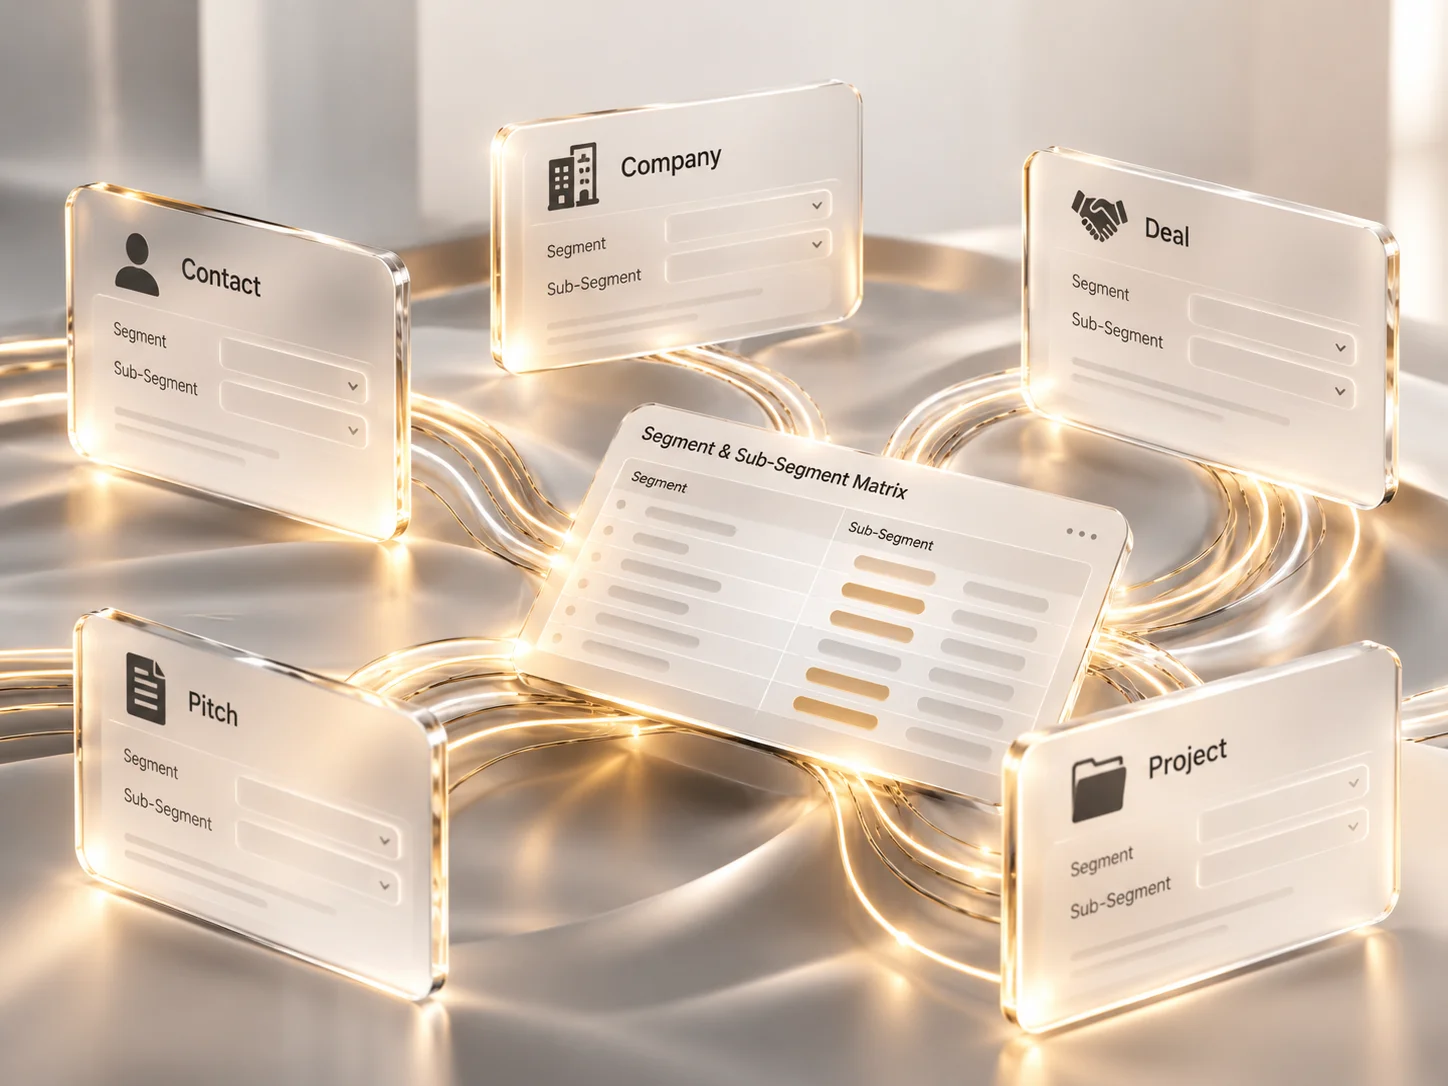
So haben wir die Branchenklassifizierung über fünf HubSpot-Objekte, darunter zwei benutzerdefinierte Objekte, standardisiert und jeden bisherigen Subsegment-Wert in ein sauberes, segmentspezifisches Modell migriert.
Projektübersicht
Der Kunde nutzt HubSpot als zentrales System für das Beziehungs- und Pipeline-Management. Jeder Datensatz wird auf zwei Ebenen einer Branche zugeordnet: einem Segment wie Healthcare oder Software und einem Subsegment zur genaueren Einordnung. Diese Struktur steuert die Listensegmentierung, das Deal- und Projekt-Reporting, die Teamzuordnung sowie die Weiterleitung von Chancen an die passenden Fachleute.
Die Klassifizierung wurde für fünf Objekte benötigt: Kontakte, Unternehmen und Deals sowie die beiden benutzerdefinierten Objekte Pitches und Projects. Über die Jahre war das Datenmodell organisch statt geplant gewachsen, sodass sich das Team nicht mehr darauf verlassen konnte.
Herausforderung
Die bestehende Struktur hatte mehrere grundlegende Probleme. Das Portal enthielt keinen HubSpot Data Hub. Damit standen Custom-Code-Actions in Workflows, automatisierte Datenqualitätsfunktionen und formelbasierte Transformationen innerhalb von HubSpot nicht zur Verfügung.
Jeder Wert aus dem Multi-Select-Feld musste auf eine von sieben Ziel-Properties verteilt werden. Mit Standard-Workflows hätte dies für jede Subsegment-Option einen eigenen Zweig auf jedem Objekt erfordert und wäre vom ersten Tag an kaum wartbar gewesen.
Einige Datensätze enthielten bereits Werte in den neuen Properties. Die Migration musste zusätzliche Werte ergänzen, ohne vorhandene Informationen zu überschreiben, und sicher mehrfach ausgeführt werden können. Der Kunde musste vor dem Schreiben genau sehen können, welche Änderungen vorgenommen werden, und anschließend über eine vollständige Audit-Historie verfügen. Jedes externe Tool musste die HubSpot-Rate-Limits einhalten und Fehler abfangen, ohne den Bearbeitungsstand zu verlieren.
Ausgangssituation
Die zunächst geprüften Ansätze erfüllten diese Anforderungen nicht. Der Kunde klassifiziert jeden Datensatz nach Segment und Subsegment über Kontakte, Unternehmen, Deals sowie die beiden benutzerdefinierten Objekte Pitches und Projects hinweg. Diese Einordnung steuert Segmentierung, Reporting, Teamzuordnung und Expert Matching.
Bei Unternehmen waren alle Subbranchen aus sämtlichen Segmenten in einem einzigen langen Multi-Select-Feld vermischt. Es gab keine Verbindung zwischen Subsegment und Segment. Falsche Zuordnungen fielen daher häufig erst auf, wenn Reports widersprüchliche Ergebnisse lieferten.
Dieselbe Klassifizierung war auf jedem Objekt etwas anders aufgebaut. Ein Healthcare-Filter bei Deals bedeutete deshalb nicht dasselbe wie bei Unternehmen. Ältere Werte enthielten zudem uneinheitliche Groß- und Kleinschreibung sowie überflüssige Leerzeichen. Reports mussten manuell abgeglichen werden, Workflows basierten auf unzuverlässigen Feldern und die Nutzer verwendeten die Klassifizierung zunehmend nicht mehr.
Lösung
Der Kunde definierte sieben Segmente und die jeweils gültigen Subsegmente. Jeder Altdatenwert wurde exakt einem Segment und einer kanonischen Option zugeordnet. Dabei wurden auch Duplikate, Schreibfehler und veraltete Bezeichnungen bereinigt.
Jedes Segment erhielt eine eigene Multi-Select-Property, die ausschließlich die dafür gültigen Optionen enthält. Die Optionswerte wurden an die bisherigen Werte angeglichen. Dadurch bleibt das Mapping direkt in HubSpot sichtbar und kann vom Kunden selbst gepflegt werden.
Ein schlankes Node.js-Skript übertrug die bisherigen Werte über die HubSpot CRM API in die neuen Properties. Es lädt die erlaubten Optionen, ruft alle Unternehmen ab, erstellt und visualisiert jede geplante Änderung und schreibt erst danach die freigegebenen Updates. Abschließend exportiert es eine Audit-CSV.
Die gleichen Properties wurden bei Kontakten, Deals, Pitches und Projects gespiegelt. Standardisierte HubSpot-Workflows halten verknüpfte Datensätze mit dem jeweiligen Unternehmen synchron – ohne Custom Code innerhalb von HubSpot.
Die Lösung blieb bewusst schlank: eine JavaScript-Datei mit axios als einziger Abhängigkeit und Authentifizierung über einen HubSpot Private App Token. Das Skript nutzt die Properties API zum Lesen der Optionen und die Objects API zum Abrufen und Aktualisieren der Unternehmen. Bei Rate-Limits und Serverfehlern werden Anfragen automatisch erneut ausgeführt. Da im Portal nichts installiert wurde, funktioniert die Lösung in jedem HubSpot-Tarif, der benutzerdefinierte Properties unterstützt.
Das Skript gleicht Werte mit den aktuellen Optionsdefinitionen ab, statt Annahmen zu treffen, und führt neue mit bestehenden Werten zusammen, sodass nichts überschrieben wird. Vor jeder Ausführung erfolgt ein Dry Run zur Prüfung durch den Kunden. Nicht zuordenbare Werte werden als Aufgabenliste protokolliert statt verworfen. Jede Ausführung erzeugt zudem eine vollständige Audit-CSV, die erklärt, warum ein Datensatz den jeweiligen Wert enthält.
Business Value / Ergebnis


